組込みデバイス向けAIモデル移植・高速化サービス
納期1/3。品質と性能は、より高く。各種組込みデバイスへの移植と、処理の高速化に対応します。
こんな企業様に
- 開発期間を短縮したい
- ターゲットHW上で性能要件を満たせない
- チップごとに移植が必要
コンピュータの
パフォーマンスエンジニアリングとは、
データ処理の
データ処理帯域を高め、スループットを向上させる。
ユーザーへの応答時間を短縮し、レイテンシを削減する。
電力効率を改善し、ワットあたりの性能を向上させる。
費用対効果を改善し、TCOを削減する。
組込み機器から
性能改善の
AIがあらゆる製品やサービスに組み込まれ、必要な計算量は増え続けています。限られた計算資源と電力で応えるには、ソフトウェアの効率化が欠かせません。
AI処理のためのプロセッサは、GPUからNPU、専用チップまで急速に増えています。同じAIモデルでも、動かすチップによって必要な最適化は大きく変わります。
AIエージェントの登場で、開発の進め方が変わりつつあります。計測と改善の繰り返しを任せられるようになり、性能改善に取り組みやすくなりました。
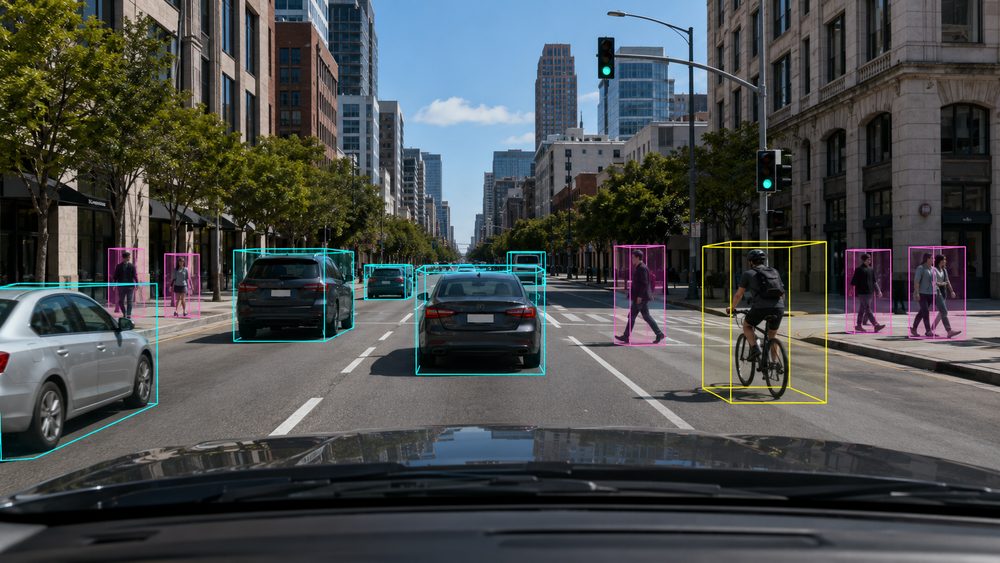
自動運転や検査装置など、AIを機器の上で直接動かす場面が増えています。限られた計算資源で、必要な性能を引き出す技術が求められます。
正しく
理論性能は
計測環境は、
計測手法や
計測ノイズが
改善したか
支配的ではない
場合に
エージェントは
確認して
AI/LLMの
納期1/3。品質と性能は、より高く。各種組込みデバイスへの移植と、処理の高速化に対応します。
コードを社外に出さずにAIを活用できる、組込みソフトウェア開発環境を構築します。
最新LLMが使えるGPUワークステーション。届いてすぐにローカルAIを運用できます。
フィックスターズは、
まずGPUの
推論レイテンシの
学習の
パフォーマンスエンジニアリングの
フィックスターズは、