ホワイトペーパー パフォーマンスエンジニアリングシリーズ06
Tenstorrent TT-QuietBoxにおける
gpt-oss-120b推論高速化の実践
PDF・全19ページ
Tenstorrent TT-QuietBox上で
主な結果
- −31.3% TPOT
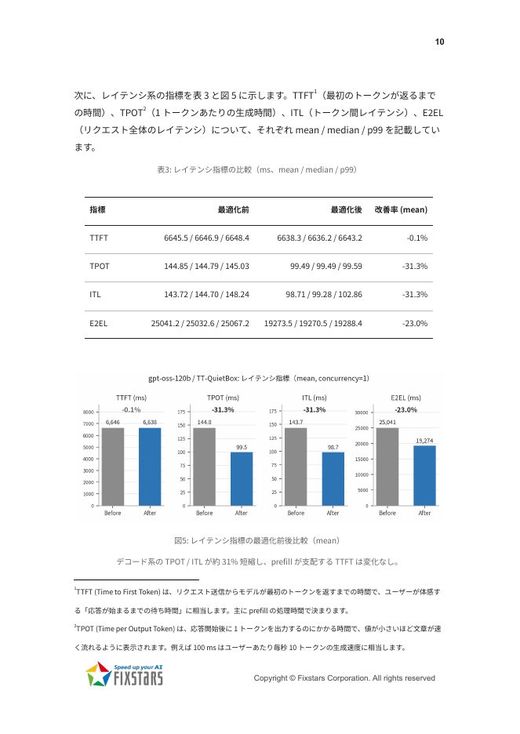
- 1トークンあたりの生成時間(TPOT)を144.85 msから99.49 msへ短縮しました。
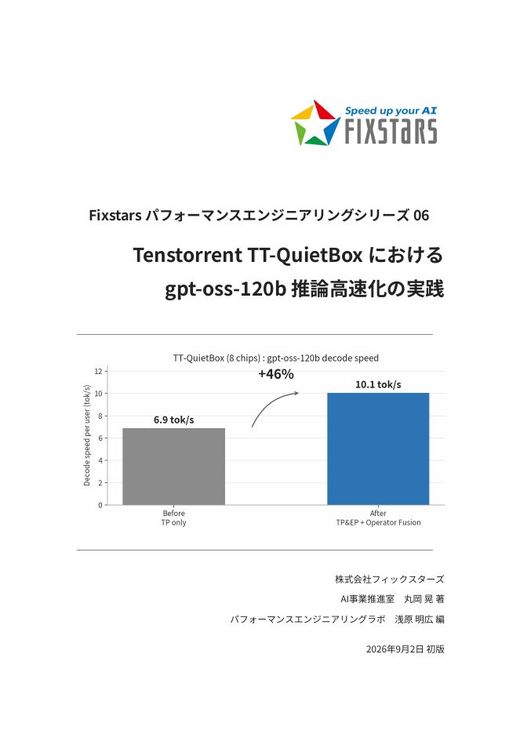
- +45.7% デコード速度
- 1ユーザーあたりのデコード速度が6.9 tok/sから10.05 tok/sへ向上しました。
- −23.0% 平均応答時間
- リクエスト全体の平均応答時間(E2EL)を25.0秒から19.3秒に短縮しました。
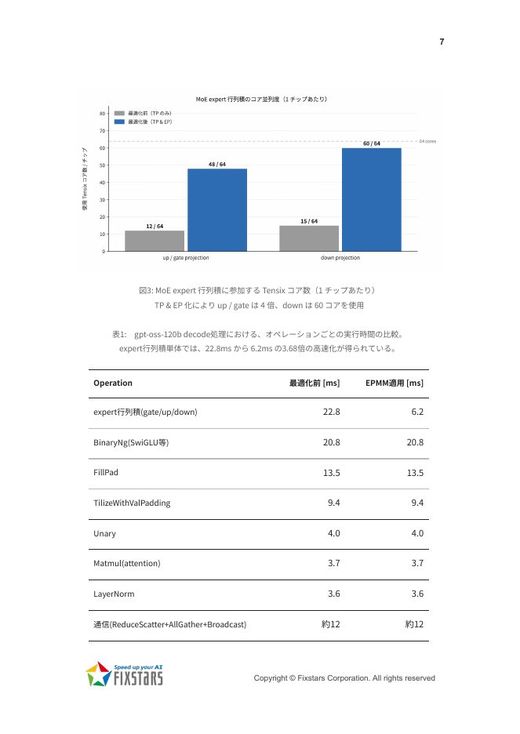
- 3.68倍 行列積の処理速度
- デコード処理の主要ボトルネックだったMoEのexpert行列積を、22.8 msから6.2 msへ高速化しました。
※ TT-QuietBox(Wormholeチップ8基、GDDR6メモリ合計96GB)、同時実行数1、入力・出力各128トークンの条件で測定
本書が取り組む課題
LLM推論基盤の選択肢が広がる一方、大規模モデルが動作しても、十分な応答速度が得られるとは限りません。TT-QuietBox上でgpt-oss-120bを動作させたところ、1ユーザーあたりのデコード速度は6.9 tok/sにとどまりました。本書では、演算コアの活用不足やカーネル起動・データ転送の負荷に着目し、限られたハードウェア資源で推論をどこまで高速化できるかを検証します。
本書の特徴
- アーキテクチャに踏み込んだボトルネック分析TensixコアとSRAMを中心とするTenstorrentの構造を解説し、MoEの行列積で演算コアを十分に活用できていない原因を分析
- 並列化と演算融合による最適化テンソル並列(TP)とエキスパート並列(EP)の組み合わせでコアの活用を促進。さらに、複数の演算を一つのカーネルにまとめるOperator Fusionで処理の負荷を削減
- 用途への適性とハードウェア選定への示唆コーディングエージェント用途に残る課題を整理し、GalaxyやBlackhole世代で期待される改善と、今後の検証項目を考察
こんな方におすすめ
- NVIDIA GPU以外のアクセラレータも含め、オンプレミスのLLM推論基盤を検討している方
- Tenstorrent上での大規模MoEモデルの推論性能や、具体的な高速化手法を知りたい方
- ハードウェアの仕様だけでなく、実測性能や用途への適性を踏まえて推論基盤を選定したい方